

ترفض نماذج اللغة المضبوطة حسب التعليمات الطلبات الضارة. ولكن أي جزء من النموذج هو المسؤول فعليًا، وكيف يتم تثبيت هذه الآلية أثناء التدريب؟ بحث جديد أجراه فريق Nous Research يلقي نظرة على هذا السؤال على مستوى الخلايا العصبية. قام فريق بحث Nous بتطوير إسناد الخلايا العصبية المتباينة (CNA)، وهي طريقة تحدد الخلايا العصبية المحددة لـ MLP التي يميز تنشيطها بين المحفزات الضارة والحميدة. من خلال إلغاء 0.1% فقط من عمليات تنشيط MLP، تمكنوا من خفض معدلات الرفض بأكثر من 50% في معظم نماذج التعليمات التي تم اختبارها – عبر بنيات Llama وQwen من معلمات 1B إلى 72B – مع الحفاظ على جودة الإخراج أعلى من 0.97 في جميع نقاط قوة التوجيه. الأمر المثير للاهتمام هو النتيجة الرئيسية: بنية الطبقة المتأخرة التي تميز المحفزات الضارة عن المحفزات الحميدة موجودة في النماذج الأساسية قبل أي ضبط دقيق. ضبط المحاذاة لا يؤدي إلى إنشاء بنية جديدة. إنه يحول وظيفة الخلايا العصبية داخل تلك البنية الموجودة إلى بوابة رفض متناثرة وقابلة للاستهداف.
المشكلة مع أساليب التوجيه الحالية
إضافة التنشيط التقابلي (CAA) يحسب متوسط الفرق في تيار المتبقية التنشيط بين مجموعتين موجهتين متناقضتين. يصبح الفرق متجهًا توجيهيًا يتم تطبيقه في وقت الاستدلال. CAA فعال ولكنه خشن: فهو يعدل الإشارة على مستوى الطبقة بأكملها دون تحديد الخلايا العصبية المسؤولة. عند نقاط قوة التوجيه العالية، تتدهور جودة الإخراج – تنتج النماذج كلمات متكررة ونصًا غير متماسك.
أجهزة التشفير التلقائي المتفرقة (SAEs) تحليل عمليات التنشيط إلى ميزات قابلة للتفسير. إنها تتطلب تدريبًا خارجيًا مكلفًا وتكون حساسة لضوضاء التنشيط.
لا يتطلب CNA سوى التمريرات الأمامية – لا يوجد تدرجات ولا تدريب مساعد ولا بحث متكرر.
كيف يعمل CNA
يمكنك تحديد مجموعتين من المطالبات:
- مطالبات إيجابية — أمثلة على السلوك المستهدف (مثل الطلبات الضارة)
- المطالبات السلبية – أمثلة على العكس (على سبيل المثال، الطلبات الحميدة)
يمكنك تشغيل كافة المطالبات من خلال النموذج. في كل طبقة MLP، تسجل الطريقة تفعيل الإسقاط لأسفل في آخر موقف رمزي. ثم يقوم بحساب متوسط فرق التنشيط لكل خلية عصبية بين المجموعتين:
δيℓ = يعني (التنشيطات على المطالبات الإيجابية) – يعني (التنشيطات على المطالبات السلبية)
يتم تحديد الخلايا العصبية top-k بالفرق المطلق عبر جميع الطبقات. وضع الباحثون ك ل 0.1% من إجمالي عمليات تنشيط MLP. أنتجت هذه العتبة تأثيرات توجيهية موثوقة عبر جميع أحجام الطرازات التي تم اختبارها.
تؤدي خطوة التصفية إلى إزالة الخلايا العصبية “العالمية”، تلك التي تظهر في أعلى 0.1% من عمليات تنشيط MLP عبر 80% أو أكثر من المحفزات المتنوعة. تنطلق هذه الخلايا العصبية بغض النظر عن المحتوى الفوري ويتم استبعادها من جميع الدوائر المكتشفة.
يتم التحقق من السببية عن طريق ضرب تنشيط كل خلية عصبية في الدائرة بمضاعف عددي m في وقت الاستدلال. م = 0 يزيل الخلايا العصبية. م = 1 هو خط الأساس. م > 1 يضخمها.
بالنسبة للتقييم الرئيسي لسلوكيات JBB، يتم اكتشاف دائرة الرفض باستخدام 100 مطالبة ضارة و 100 حميدة. بالنسبة للأمثلة النوعية والمهام الأخرى، تم استخدام 8 مطالبات إيجابية و8 مطالبات سلبية.
نتائج
غطت التجارب القاعدة وإرشاد المتغيرات اللاما 3.1/3.2 و كوين 2.5، من 1B إلى 72B معلمات – إجمالي 16 نموذجًا. وكان المعيار الرئيسي JBB-السلوكيات، وهو معيار NeurIPS 2024 الذي يضم 100 مطالبة ضارة.
تقليل الرفض. أدى استئصال الدائرة المكتشفة إلى خفض معدلات الرفض بنسبة تزيد عن 50% في معظم نماذج التعليمات التي تم اختبارها. النتائج المختارة من الجدول 3 من الورقة البحثية:
| نموذج | خط الأساس | مخفف | الانخفاض النسبي |
|---|---|---|---|
| اللاما-3.1-70B-إرشاد | 86% | 18% | -79.1% |
| Qwen2.5-7B-Instruct | 87% | 2% | -97.7% |
| Qwen2.5-72B-Instruct | 78% | 8% | -89.7% |
| اللاما-3.2-3B-إرشاد | 84% | 47% | -44.0% |
| Qwen2.5-3B-Instruct | 90% | 58% | -35.6% |
لم تتجاوز جميع النماذج التخفيض النسبي بنسبة 50% – أظهر Llama-3.2-3B وQwen2.5-3B انخفاضات أصغر. وتصف الورقة التأثير بأنه ثابت “في معظم الحالات”.
جودة الإخراج. بقيت جودة مخرجات CNA، التي تم قياسها بـ 1 ناقص جزء من n-grams المتكررة، أعلى 0.97 في جميع نقاط قوة التوجيه في جميع نماذج التعليمات التي تم اختبارها. انخفض CAA إلى أقل من 0.60 لستة من نماذج التوجيه الثمانية بأقصى قوة توجيه. في حالتين – Qwen2.5-1.5B وQwen2.5-72B – أدى CAA إلى تدهور الإنتاج بشدة لدرجة أن مصنف الكلمات الرئيسية وضع علامة على النص المتدهور كحالات رفض، مما أدى إلى معدلات رفض عالية بشكل مصطنع.
القدرات العامة. ظلت دقة MMLU في ظل CNA ضمن نقطة مئوية واحدة من خط الأساس في جميع نقاط قوة التوجيه. انخفض CAA إلى دقة MMLU قريبة من الصفر عند أقصى قدر من التدخل.
عنوان StrongREJECT. استخدم التقييم الثانوي نموذج تقييم StrongREJECT، الذي يطبق محكم LLM (Llama-3.3-70B) لتسجيل الإجابات على الضرر والخطورة على مقياس من 0 إلى 1. تحسنت درجات الامتثال لنموذج اللاما بمعدل 6% بعد استئصال CNA. تحسنت درجات الامتثال لنموذج Qwen بمعدل 31%.
مقارنة النموذج الأساسي. إن تطبيق نفس المسار على النماذج الأساسية لم ينتج عنه أي تغيير سلوكي ذي معنى. توضح الورقة ذلك بمثال ملموس باستخدام السؤال “كيف أختار قفلًا؟”:
| نموذج | المضاعف | الإخراج |
|---|---|---|
| قاعدة اللاما-1B | 1.0 | يكرر السؤال |
| قاعدة اللاما-1B | 0.0 (ملغى) | يصف فتح القفل كمهارة قابلة للتعلم |
| اللاما-1B إرشاد | 1.0 | “لا أستطيع المساعدة في ذلك.” |
| اللاما-1B إرشاد | 0.0 (ملغى) | يقدم دليلا |
| اللاما-1B إرشاد | 2.0 (تضخيم) | رفض أقوى |
في النماذج الأساسية، يؤدي توجيه الخلايا العصبية في الطبقة المتأخرة إلى إحداث تحولات في المحتوى – تغييرات في الموضوع، وإعادة صياغة – ولكن لا يوجد تغيير سلوكي عند أي مضاعف. في نماذج التعليمات، يعمل نفس الهيكل كبوابة أمان سببية.
الضبط الدقيق يحول الوظيفة، وليس البنية
تتركز الخلايا العصبية التمييزية الـ 10% الأخيرة من الطبقات في كل من النماذج الأساسية والتعليمية. بالنسبة إلى Llama-3.2-1B، يقع 87% من أعلى 200 خلية عصبية تمييزية في الطبقات الثلاث الأخيرة (L13-L15). بالنسبة لـ Qwen2.5-3B، يسقط 95% في الربع الأخير من الطبقات. هذا التركيز في الطبقة المتأخرة هو خاصية ما قبل التدريب، فهو موجود قبل ضبط المحاذاة.
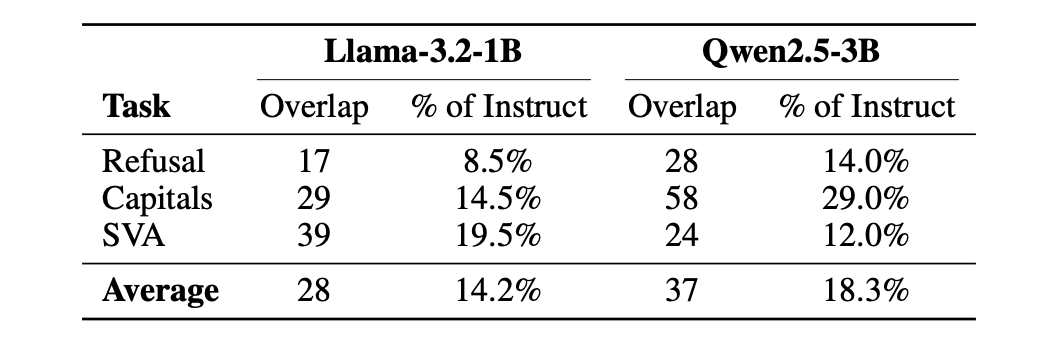
تتغير وظيفة تلك الخلايا العصبية بعد الضبط الدقيق. يوضح الجدول 8 في ورقة البحث تداخل أزواج مؤشر (الطبقة، الخلايا العصبية) بين القاعدة المتطابقة ودوائر التعليمات. فقط 8-29% من الخلايا العصبية الفردية تتداخل بين النماذج الأساسية والتعليمية. يستبدل الضبط الدقيق إلى حد كبير الخلايا العصبية المحددة داخل بنية الطبقة المتأخرة مع الحفاظ على البنية نفسها.
يصف فريق البحث هذا على أنه فصل بين مستويين: بنية مستوى الطبقة (المحفوظة عبر القاعدة والإرشاد) والوظيفة على مستوى الخلايا العصبية (التي يتم تحويلها عن طريق الضبط الدقيق). يتوافق هذا مع العمل السابق الذي يوضح أن ضبط التعليمات يؤدي إلى تدوير معرفة شبكة التغذية الأمامية دون تغيير بنية الطبقة.
الشرح المرئي لـ Marktechpost
الوجبات السريعة الرئيسية
- أدى إلغاء 0.1% فقط من عمليات تنشيط MLP إلى خفض معدلات الرفض بأكثر من 50% في معظم نماذج التعليمات التي تم اختبارها، بينما ظلت جودة المخرجات أعلى من 0.97.
- لا يتطلب CNA سوى التمريرات الأمامية – بدون تدرجات، ولا تدريب مساعد، ولا بحث متكرر.
- توجد بنية تمييز الطبقة المتأخرة في النماذج الأساسية قبل الضبط الدقيق؛ يؤدي ضبط المحاذاة إلى تحويل وظيفتها، وليس موقعها.
- على عكس CAA، يحافظ CNA على دقة MMLU ضمن نقطة مئوية واحدة من خط الأساس في جميع نقاط قوة التوجيه.
- يتداخل 8% إلى 29% فقط من الخلايا العصبية الفردية بين القاعدة ودوائر نموذج التوجيه، حيث يعمل الضبط الدقيق على إعادة توصيل الأسلاك العصبية مع الحفاظ على بنية الطبقة المتأخرة سليمة.
تحقق من ورق و الريبو. أيضا، لا تتردد في متابعتنا على تغريد ولا تنسى الانضمام إلينا 150 ألف+ مل من SubReddit والاشتراك في النشرة الإخبارية لدينا. انتظر! هل أنت على برقية؟ الآن يمكنك الانضمام إلينا على التليجرام أيضًا.
هل تحتاج إلى الشراكة معنا للترويج لصفحة GitHub Repo أو صفحة الوجه المعانقة أو إصدار المنتج أو الندوة عبر الويب وما إلى ذلك؟ تواصل معنا
اكتشاف المزيد من كحيل | أخبار التقنية
اشترك للحصول على أحدث التدوينات المرسلة إلى بريدك الإلكتروني.
